
为什么我们公司的OA这么难用?
为什么我们公司的OA这么难用?做了5年泛微二次开发。 被问过最多的一句话是: “为什么我们公司的OA这么难用?” 每次听到这句话,我都想反问一句: 你知道你那套OA,是怎么被做成这样的吗? 我接手过一个出差申请流程功能描述很简单: 员工填出差申请,输入开始日期和结束日期,下面自动生成出差计划明细——每天一行,填写当天的工作内容。 听起来很普通,对吧。 但我打开这个流程的时候,愣了一下。 设计者的解法:建15张表原来的设计者不会写JS。 他的解法是: 用关联台账表来生成明细行。 出差1天,关联第1张表。 出差2天,关联第2张表。 出差3天,关联第3张表。 …… 出差15天,关联第15张表。 所以他建了15张表。 字段名整整齐齐: uf_ccsqmrgz1uf_ccsqmrgz2uf_ccsqmrgz3……uf_ccsqmrgz15 最大支持15天出差。 超过15天?不支持。 这不是解决问题,这是在绕开问题我不是要嘲笑这个设计者。 能把功能跑通,说明他花了时间,也花了心思。 但这个方案有一个根本问题: 他在用数据堆砌来替代逻辑。 JS可以做的事,他用15张表来模拟。 结果就是:...
《Ecolog9—飞书工作台串联泛微 OA 与携程企业差旅 SSO 单点登录实践》
飞书工作台串联泛微 OA 与携程企业差旅 SSO 单点登录实践背景公司使用泛微 e-cology(Weaver)作为 OA 平台,飞书作为企业 IM 和工作台,携程企业差旅作为出行管理平台。 员工日常在飞书工作台内处理审批事务,差旅申请审批通过后需要直接跳转到携程平台预订机票、火车票、酒店。要实现这个体验,涉及两段 SSO 串联: 12345678飞书工作台 │ 飞书网页应用(开发者后台配置) │ 通过飞书连接器获取 token ▼泛微 OA(已建立登录态) │ OA 内调用携程 SSO 接口 ▼携程企业差旅(已建立登录态,直达预订页) 第一段:飞书通过网页应用单点登录能力,经连接器携带 token 跳转到 OA,在 OA 侧完成身份核验并建立 OA Session。 第二段:OA 内触发携程 SSO,基于已有的 OA 登录态识别出当前员工,向携程申请跳转凭证,构造签名 URL,员工无感跳转到携程。 本文重点记录第二段的实现细节,即 OA 到携程的 SSO 方案。携程企业差旅提供了标准接入方案,分为 PC 端和 H5 移动端两种链接形态。 飞书连接器配置属于平台...
《Ecology9—自动化生成开票模板案例》
背景公司每月需要根据供应商发来的商品结算单,向税局申报开具发票。原来的流程大致是这样的: 财务收到结算单 Excel,明细行通常有 100+ 条 逐行对照内部商品税目档案,手动填写税局规定的”发票开具项目信息导入模板” 上传到电子税务局 整个过程纯手工,单份结算单少则半小时,出错了还要重来。更麻烦的是,结算单里的商品编码和税局要求的税收分类编码是两套体系,需要人工翻译,稍不注意就会填错。 这个需求落到我头上,决定用 OA 系统把这个流程自动化掉。 整体方案123456789上传结算单 xlsx ↓解析写入 OA 数据库(主表 + 明细表) ↓关联商品税目维护表(按商品编码匹配) ↓读取税局模板文件,填充数据 ↓生成文件,上传 OA 附件,返回 fileid 技术栈:Java 8 + 泛微 e-cology(JAX-RS)+ Apache POI 一、结算单 Excel 解析结算单的格式是固定的:前 5 行是表头信息,第 6 行是列标题,第 7 行起是商品明细,最后一行是合计行(不要)。 文件接收 泛微平台不支持 javax.ser...
《Ecology9—携程企业差旅集成案例》
携程企业差旅集成 一、背景公司员工出差需要自行在携程企业版上预订机票、火车票和酒店。原来的流程是:员工先在 OA 提交出差申请,审批通过后再去携程自行下单,两个系统完全割裂,存在以下问题: 无法管控行程范围:员工可以订任何日期、任何城市,与申请的出差计划不一致 无从追溯订单:订单数据在携程,OA 里不知道实际订了什么 重复出行没有提醒:同一行程多人重复申请,无人知晓 账号靠人工维护:员工入职/离职后,携程账号需要 IT 手动开通/关闭,漏操作时有发生 二、目标将 OA 差旅审批流与携程企业差旅平台打通,实现: 审批通过后自动下发”差旅授信单”,员工只能在授权范围内订票 订单状态实时回写到 OA,行程一目了然 出票/改签自动通知行政管家 员工入职/离职自动同步携程账号 提交前检测行程冲突,避免重复申请 三、涉及流程节点 节点 触发时机 做什么 提交前校验 员工点击提交时 检测同行人是否存在行程冲突(酒店日期重叠 / 交通路线重复) 审批通过 流程通过时 向携程推送差旅授信单(机票/火车票/...
《Ecology9—自动化发票生成案例》
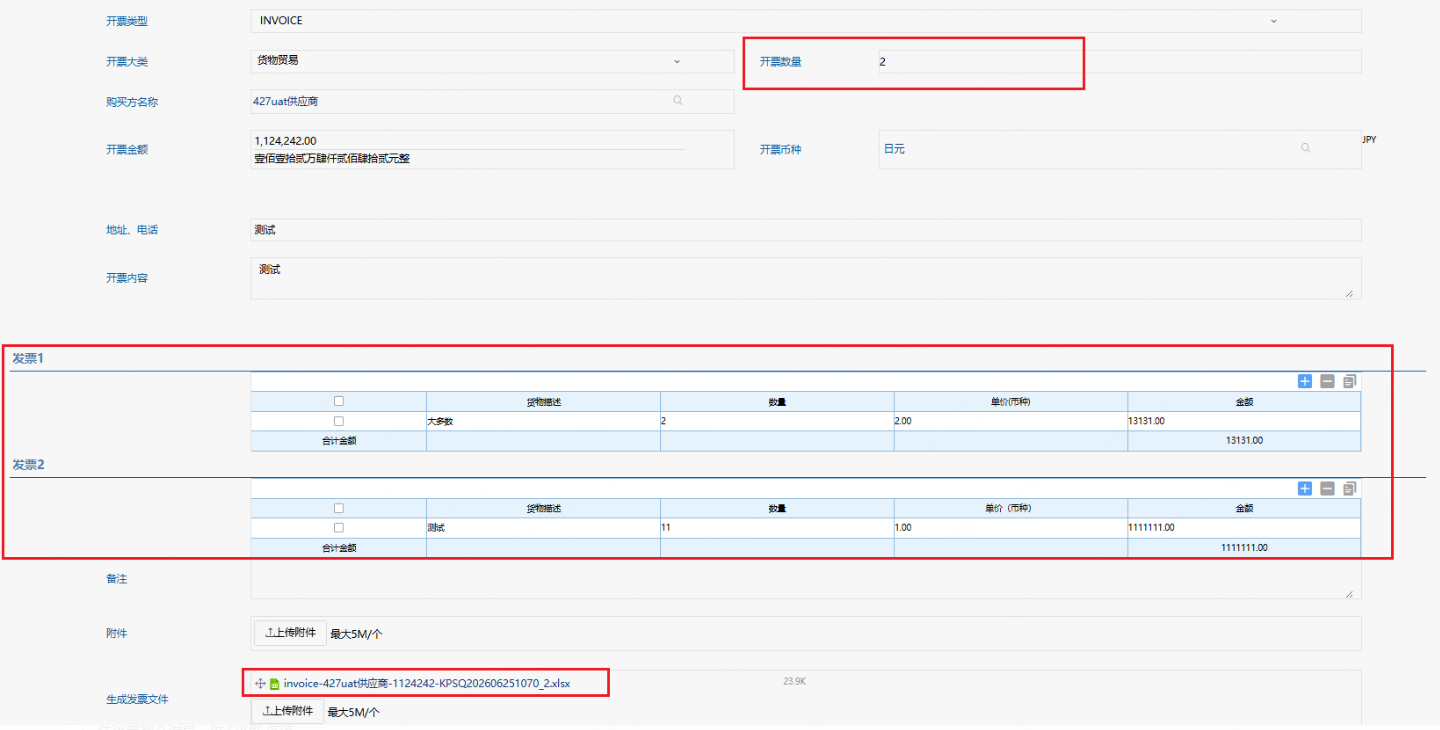
发票信息自动生成 Excel 发票文件,解决了什么问题?最近做了一个小功能:用户在系统中填写发票信息后,系统会自动根据模板生成 Excel 格式的发票文件(Invoice),并自动挂到流程附件中。 这个功能看起来不大,但在实际业务中,确实解决了不少问题。 效果展示1. 流程填写用户在流程表单中录入发票抬头、金额、币种、明细等信息。 2. Excel 自动生成提交后,系统根据表单数据自动生成对应的 Excel 发票文件,并作为附件回挂到流程中。 3. 最终打印效果生成后的文件可以直接用于查看、打印或发送给客户。 解决了哪些问题?1. 减少人工重复录入以前处理发票文件时,往往需要走两步: 在流程里填写一遍信息 再手动打开 Excel 模板,把内容复制进去 现在变成了: 用户只填一次表单 系统自动生成发票文件 这样可以减少重复劳动,也让数据来源更加统一。 2. 降低人工出错率手工制作发票文件时,常见问题包括: 客户名称填错 金额、数量、单价不一致 币种写错 明细漏填或错位 多张发票拆分错误 现在发票内容直接来自表单数据,减少了人工复制粘贴,自然也降低了出错概率。...
查询embedding模型维度
import os, requestsfrom dotenv import load_dotenvload_dotenv()url = LLM_BASE_URL + ‘/embeddings’r = requests.post(url, headers={‘Authorization’: ‘Bearer ‘ + LLM_BASE_URL_KEY}, json={‘model’: ‘google/gemini-embedding-2-preview’, ‘input’: ‘test’, ‘encoding_format’: ‘float’}, timeout=30).json()print(‘actual dim =’, len(r[‘data’][0][‘embedding’]))
Windows安装postgresSQL插件闭坑指南
Windows 上从零装好 PostgreSQL + pgvector(含全部踩坑实录) 场景:公司机器禁装 Docker,必须本机直装 PG 并启用 pgvector。环境:Windows 10/11,PostgreSQL 16(自定义安装路径 E:\pgSQL\16),pgvector 0.8.1。全程实战记录,所有”奇怪报错”都来自真实尝试。 0. 路线选择Windows 上启用 pgvector 有三条路: 方案 优点 缺点 Docker 镜像 pgvector/pgvector 5 分钟搞定 公司禁装 Docker 时不可用 下载社区预编译 DLL 不用编译 PG 主版本号必须严格对齐,新版本可能没人编 MSVC 源码编译 任何 PG 版本都能搞 流程长,坑多 本文走第三条。 1. 装 PostgreSQL去 https://www.postgresql.org/download/windows/ 下载安装器。 关键勾选: ☑️ Development files(默认不勾,必须手动勾上) 不勾的话,PG 安装目录里没有 lib...
《Ecology9——飞书账号与部门自动化》
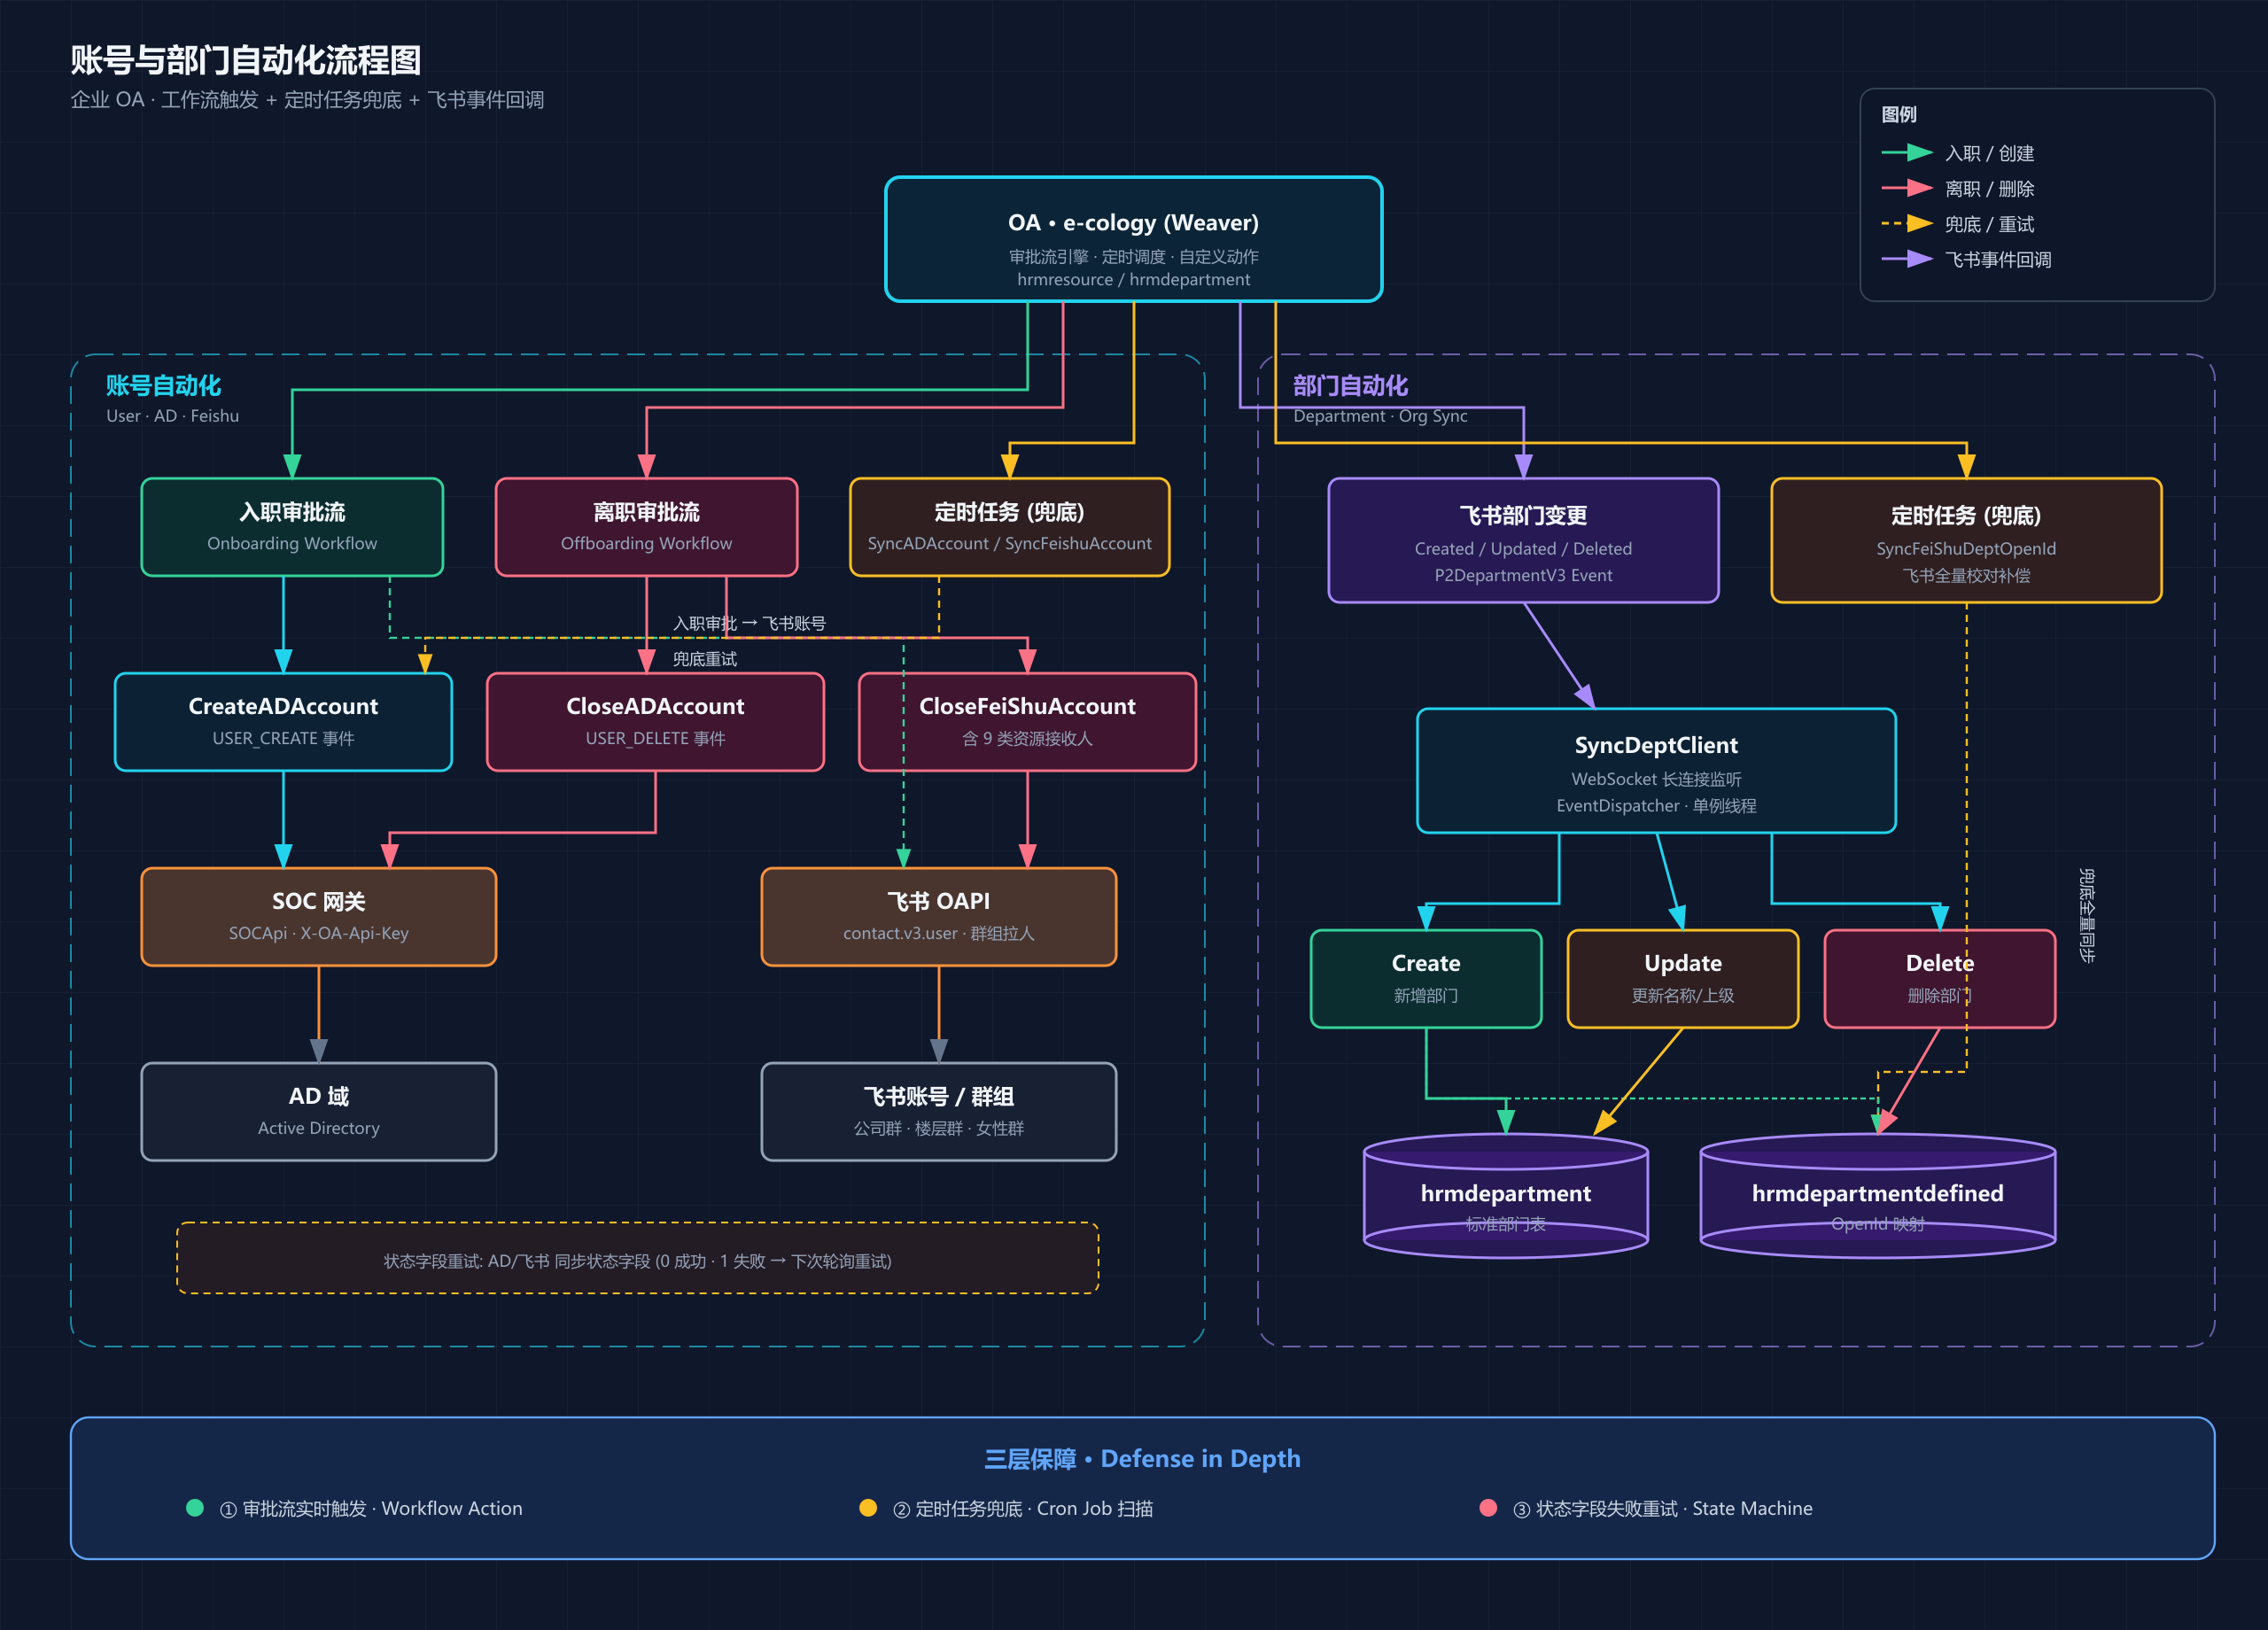
飞书账号与部门自动化 内部文档 · 面向产品与研发对齐 一、背景公司使用飞书作为主要 IM 与协同工具。员工入职后需要有飞书账号才能正常办公,离职后账号需及时关闭以防数据泄露。与此同时,公司组织架构在飞书侧频繁调整,OA 侧的部门数据却长期依赖人工同步,经常出现两边不一致的情况。 主要问题: 入职开号慢:IT 需要人工在飞书后台创建账号,新员工第一天经常没有账号 离职账号不及时关:存在安全隐患,文档、日历等资源归属不明 部门数据两张皮:飞书调整了组织架构,OA 要手动跟着改,容易遗漏 新员工拉群靠人工:需要 HR 手动把新人加入公司群、楼层群等 二、目标 员工入职审批通过后,自动创建飞书账号并拉入对应群组 员工离职后,自动关闭飞书账号并完成 9 类资源的继承交接 飞书侧组织架构变更后,OA 部门数据实时自动同步 所有操作有失败告警和自动重试机制 三、账号自动化3.1 入职开号触发方式一:审批流节点(实时) 入职审批通过后立即触发 校验 OA 账号是否已创建,若无则跳过并告警 调用飞书 contact.v3.user.create 创建账号 创建成功后: 将飞书 O...
测试环境一键发布代码脚本
打包上传com目录为com.zip,之后将com.zip放到tmp目录下执行该脚本即可 12345#!/bin/bashmv /tmp/com.zip /usr/weaver/ecology/classbeanunzip -o /usr/weaver/ecology/classbean/com.zip -d /usr/weaver/ecology/classbeansh /usr/weaver/Resin/bin/resin.sh restarttail -f /usr/weaver/Resin/log/stdout.log
写一个能跑的企业 Agent —— 一个月,30 个 skill,几条架构上的取舍
写一个能跑的企业 Agent —— 一个月,30 个 skill,几条架构上的取舍起点:我想要一个能干活的 Agent去年开始我陆续看了不少 Agent demo,做的事都很漂亮——会查天气、会订机票、会帮你算 GitHub commit 数。问题是这些 demo 跑的是公开 API 和合成数据。我想做一个能在我自己工作场景里真用得上的 Agent:每天打开它,问一些原本得自己写 SQL / 点十几下后台的问题,它能直接给我答案。 我们公司用泛微 E9,几千张表,上百个流程。这正好是个合适的”靶子”——边界清晰、数据足够多、问题足够杂。我没想做通用 Agent,就想做一个专用、稳定、长期能维护的东西。 写到现在大概一个月,30 个 skill,覆盖了我们公司日常 OA 查询的绝大部分场景。这篇主要谈架构上的几个取舍——哪些是我一开始就想对的,哪些是我后来才搞明白的,哪些是我撞墙之后才学到的。 为什么不用 LangChain / LangGraph第一个决定是不用框架。 我知道这听起来像是 NIH。但我开始动手的时候,就想清楚一件事:Agent 这个东西最终拼的...